Om prosjektet
Dette prosjektet handler om å utvikle og sammenligne to ulike typer AI-agenter som kan spille airhockey: én basert på forhåndsdefinerte regler og én som lærer gjennom maskinlæring. Målet er å undersøke hvordan ulike AI-tilnærminger håndterer et raskt og dynamisk spillmiljø, samt hvilke styrker og svakheter som følger hver metode.
Den regelbaserte agenten ble programmert med enkle regler for hvordan den skulle bevege seg og reagere på puckens posisjon og bevegelse. Dette resulterte i forutsigbar og stabil atferd, og løsningen var rask og enkel å implementere. Ulempen er at agenten ikke kan tilpasse seg nye situasjoner eller forbedre prestasjonen sin over tid.
Deretter utviklet vi en læringsbasert agent ved hjelp av forsterkende læring (Reinforcement Learning). Denne agenten lærte gjennom prøving og feiling, der den mottok belønning for handlinger som førte til ønskede utfall, som å blokkere et mål eller treffe pucken. Til tross for at læringsprosessen krevde mer tid, åpnet denne tilnærmingen for mer fleksibel og kompleks atferd. En slik agent kan justere seg til nye situasjoner og finne løsninger som ikke er eksplisitt kodet inn.
Ved å sammenligne de to agentene, fikk vi innsikt i hvilke typer oppgaver som passer best for regelbasert styring, og når det er fordelaktig å bruke en læringsbasert modell. Erfaringene fra prosjektet har overføringsverdi til flere områder, blant annet robotikk, spillutvikling og autonome systemer, der både regelbaserte og lærende AI-modeller kan anvendes på ulike måter.
Bilder:
-
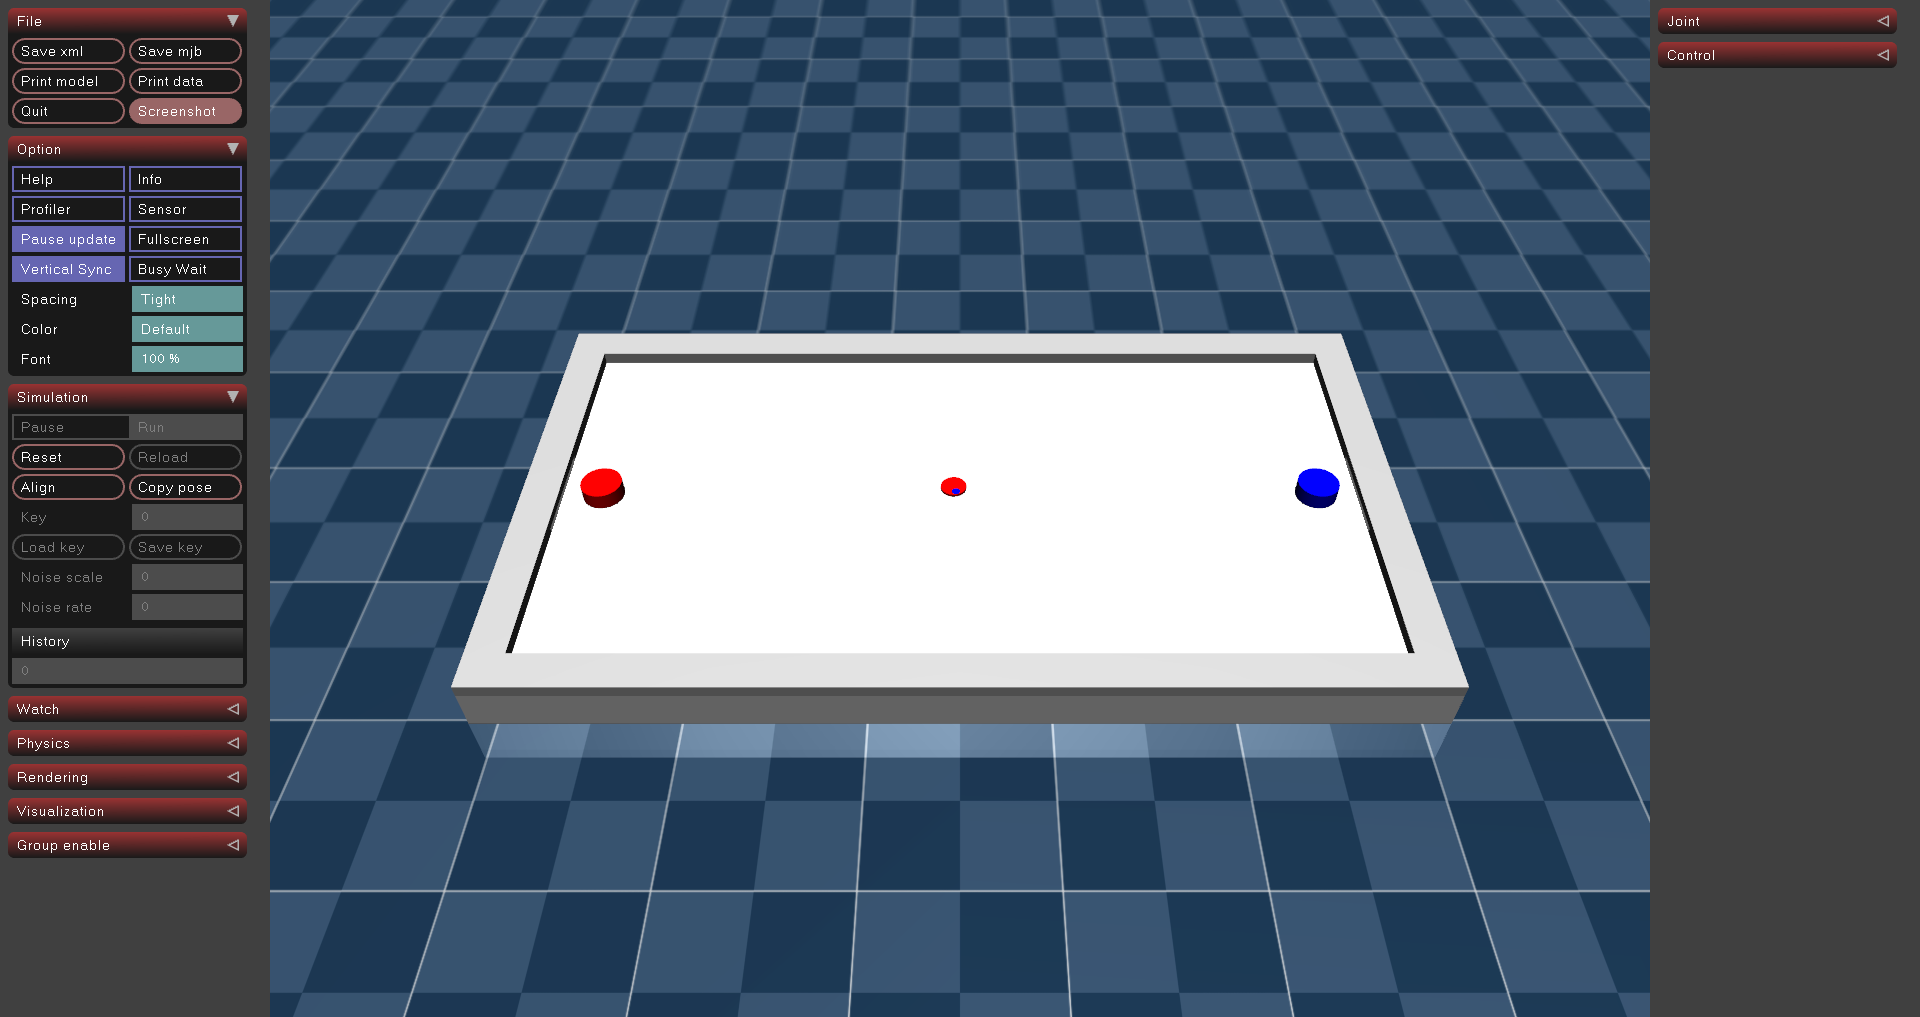
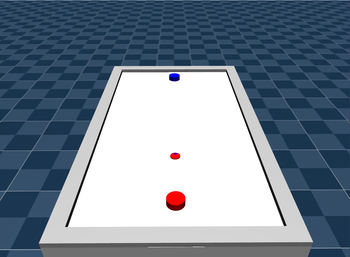
Simuleringsmiljø for AI-agenter
-
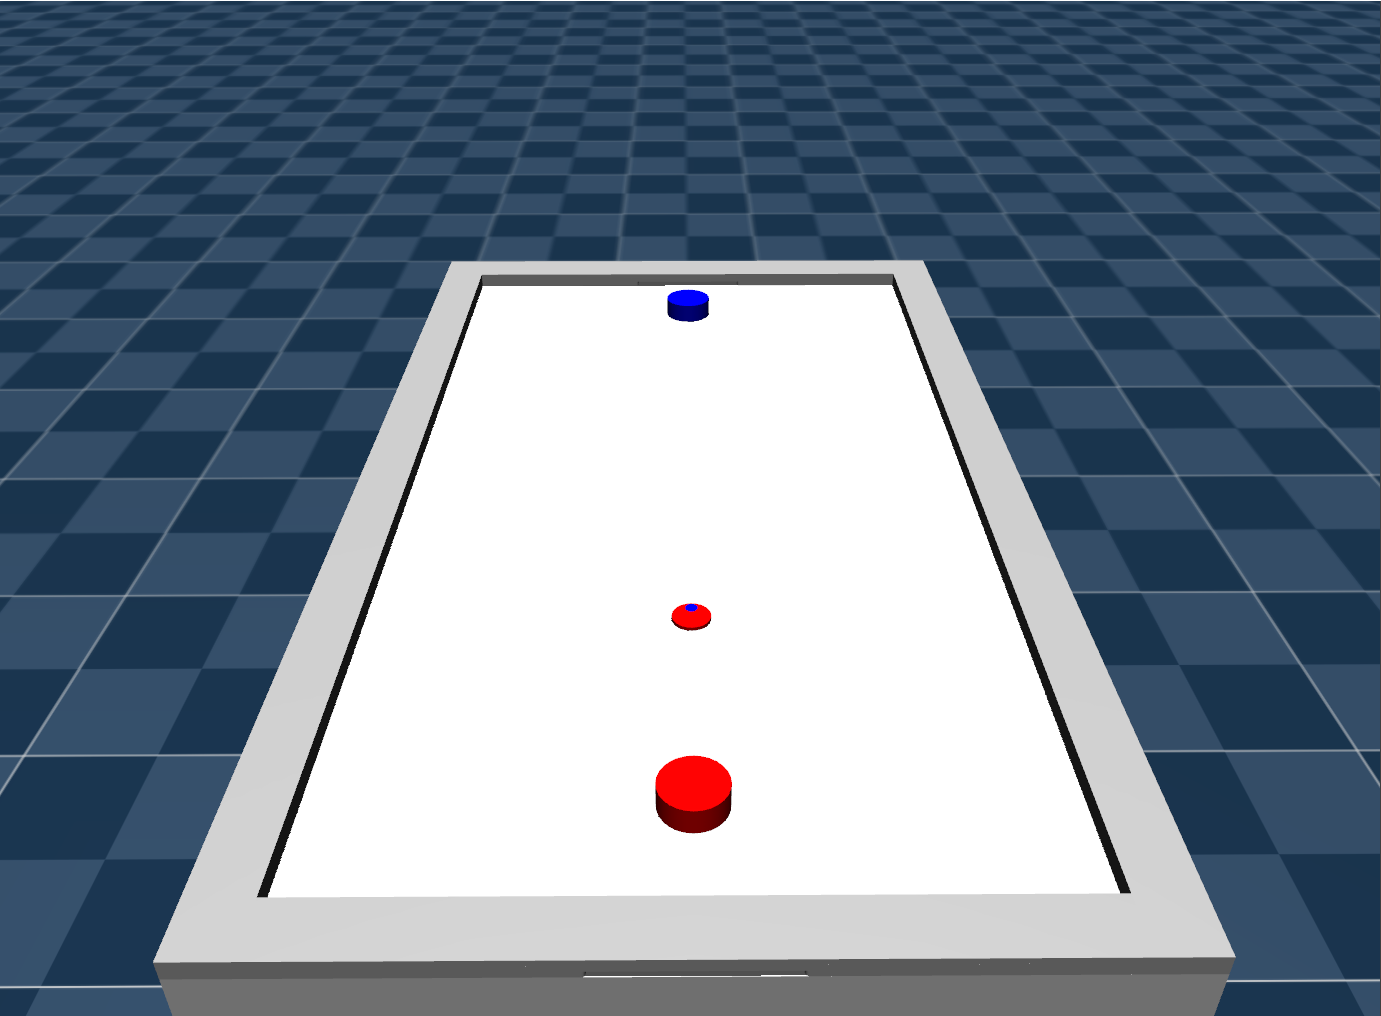
Simuleringsmiljø for AI-agenter
Prosjektdeltakere
Richard André Minge, Krister Wallin Hognestad og Mustafa Sahin
Om oppdragsgiveren
Høgskolen i Østfold Fakultet for informasjonsteknologi, ingeniørfag og økonomi Institutt for informasjonsteknologi og kommunikasjon
Veileder
Vikash Katta